
上一期:毕业设计项目:基于容器化的金融交易流水跨区域协同异常检测系统设计与实现-开发日记-01-环境搭建 - 滕王阁
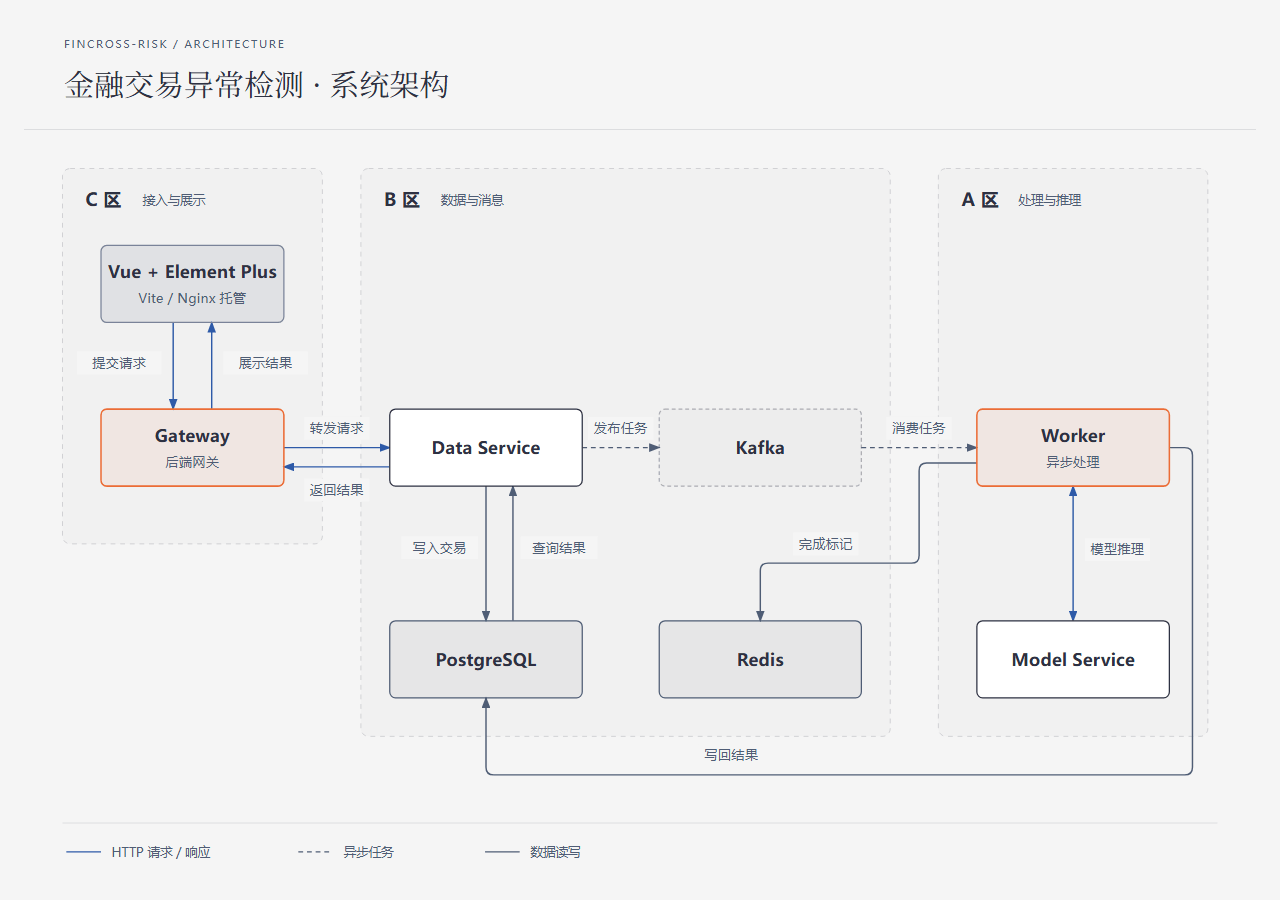
这次就是核心服务的具体实现了,主要是后端部分,前端后面再做,再放一下完整架构图。
一、C 区 Gateway
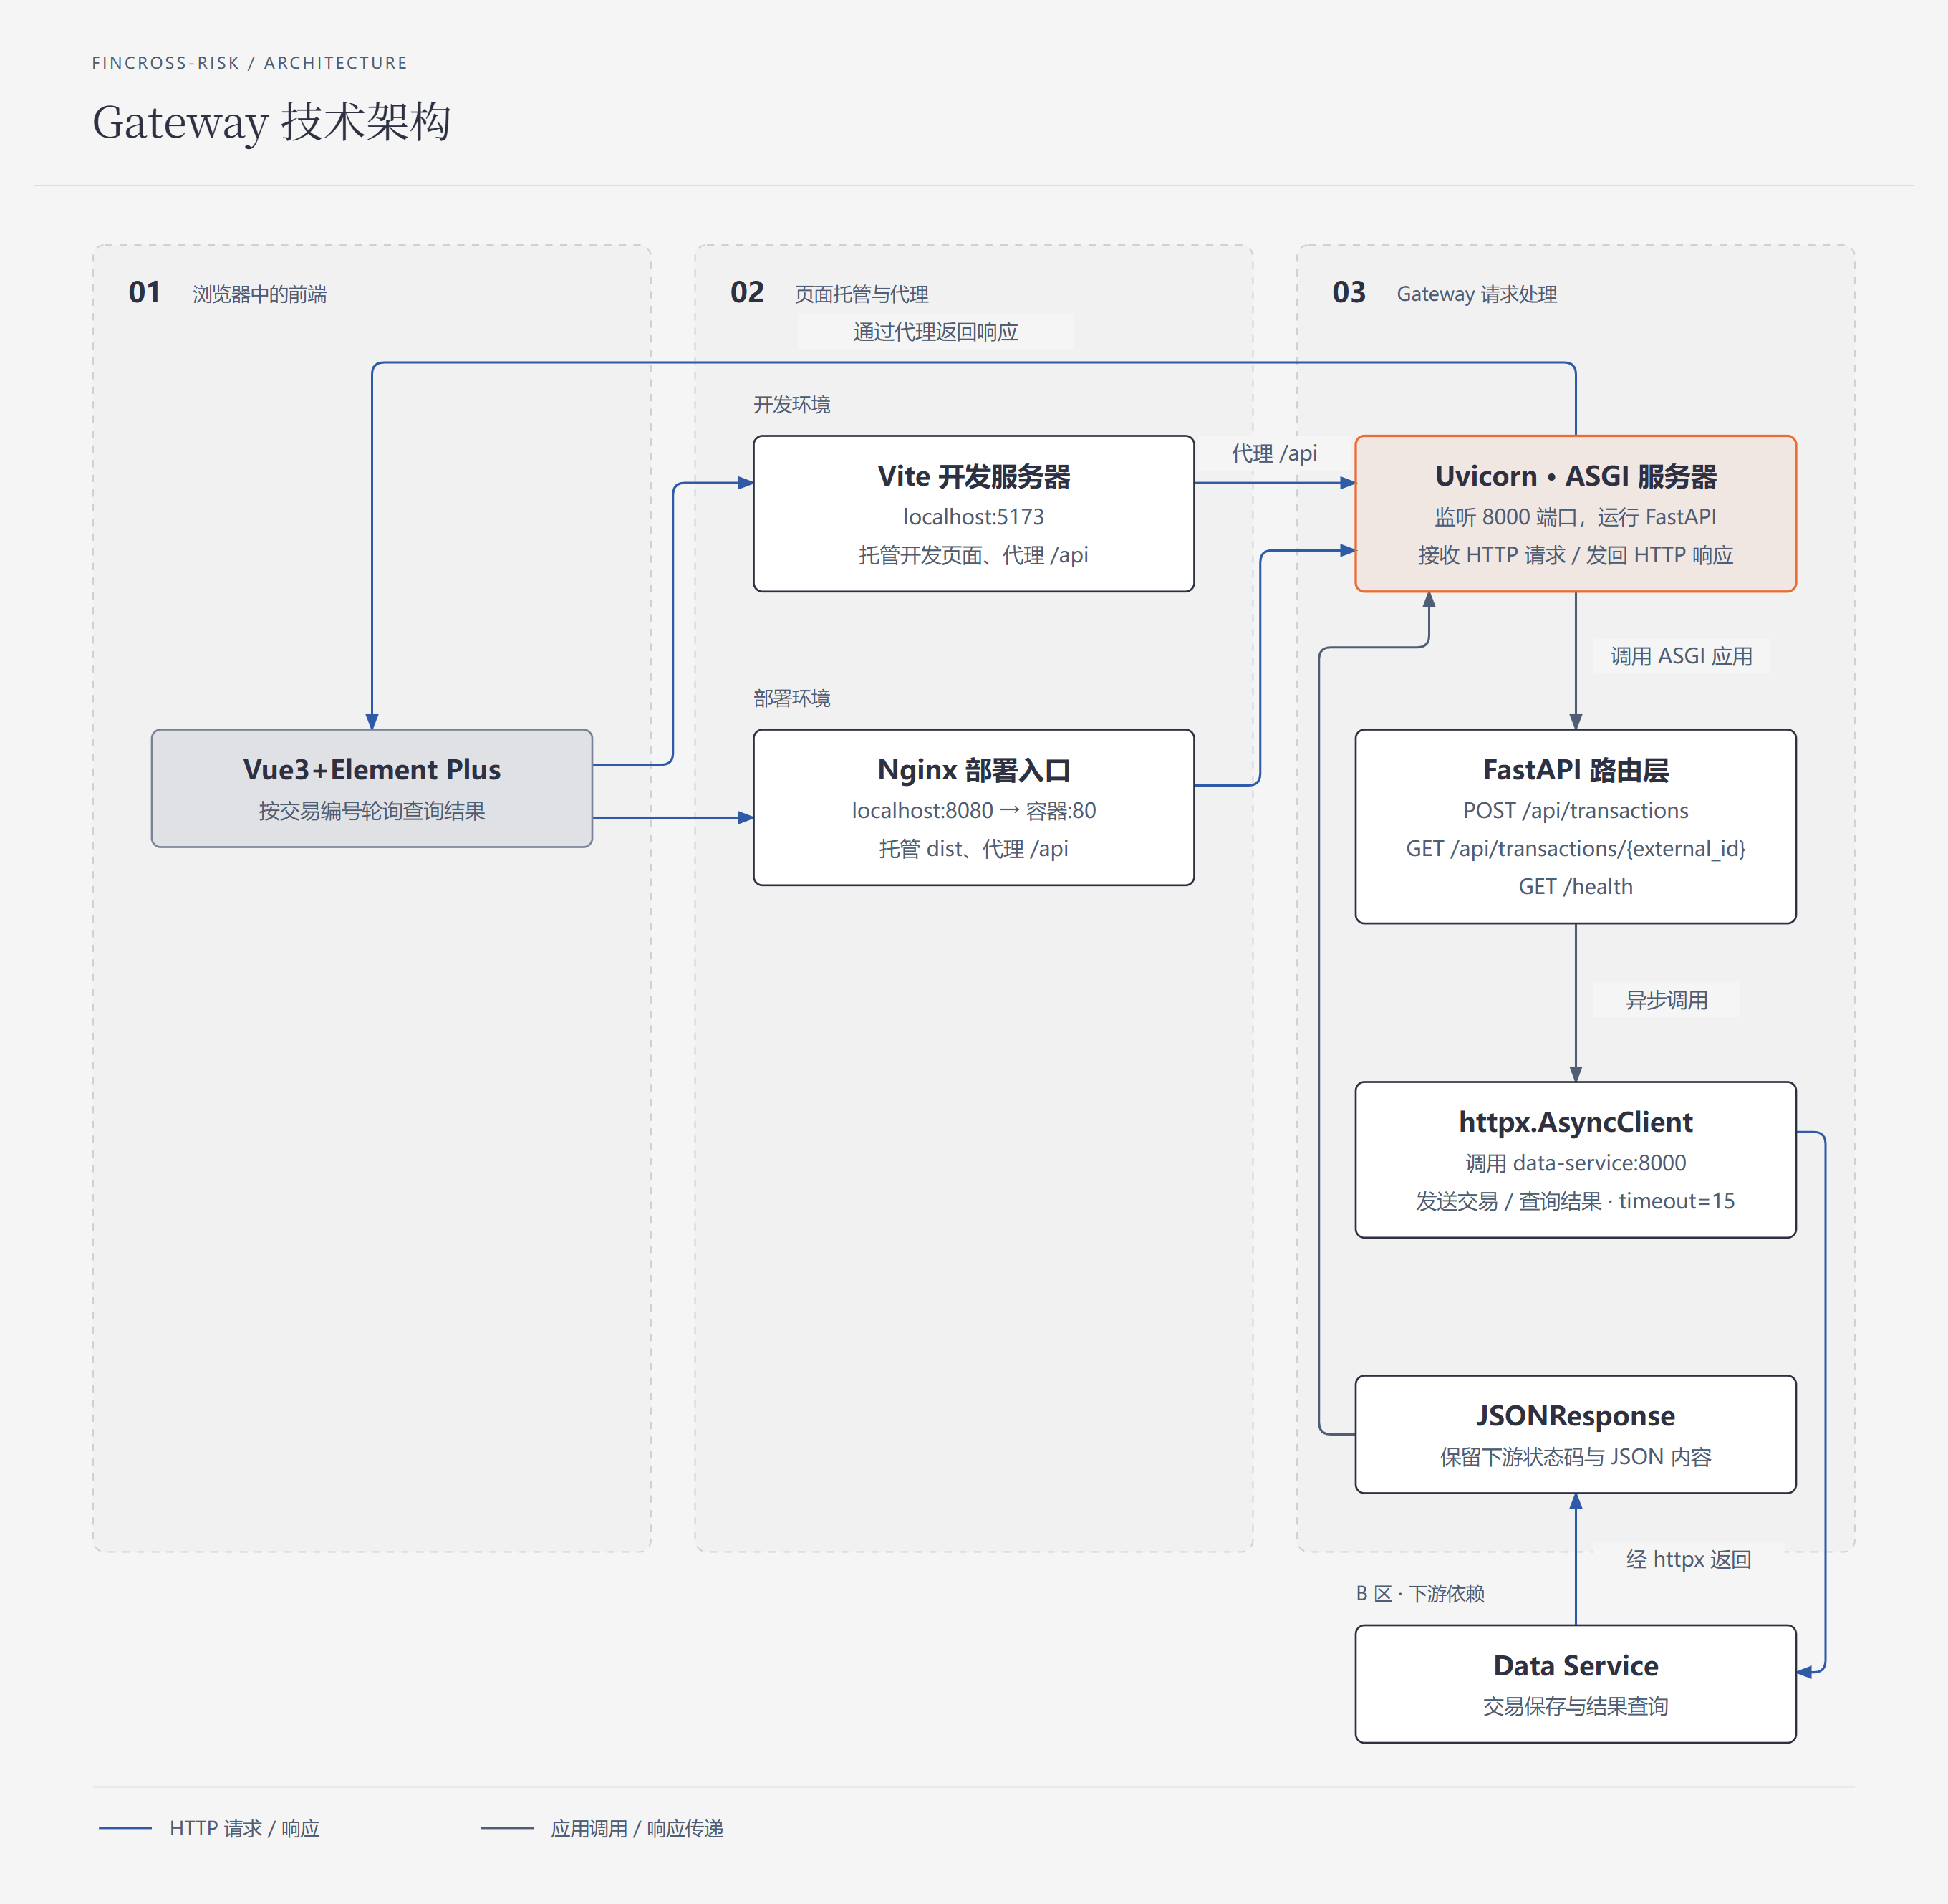
Gateway 是 C 区面向外部的统一业务 API 入口。使用 FastAPI 定义 HTTP 接口,使用 Uvicorn 启动服务,使用 httpx 以异步 HTTP 方式调用 Data Service;Dockerfile 负责把这三个部分打包进容器。
1、创建依赖文件 requirements.txt
创建依赖清单文件:apps/gateway/requirements.txt,这是一份 Python 依赖清单,在后续使用 Docker 镜像构建命令时,对应服务的 Dockerfile 会自动读取依赖清单并安装依赖。
fastapi
uvicorn[standard]
httpx
| 依赖 | 作用 |
|---|---|
fastapi |
Python Web 框架。用于定义业务逻辑接口。本身不能直接对外服务,需配合 ASGI 服务器。 |
uvicorn[standard] |
ASGI 服务器。用于监听端口、接收 HTTP 请求,通过 ASGI 协议交给 FastAPI 处理,再把结果返回客户端。[standard] 附带高性能依赖,让服务更快。 |
httpx |
HTTP 客户端。用于主动发送 HTTP 请求。 |
2、创建镜像构建文件 Dockerfile
创建镜像构建文件:apps/gateway/Dockerfile,这一份的镜像构建指令清单,列出构建 Docker 镜像所需的每一步,由 docker build 读取并逐条执行。
FROM python:3.12-slim
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY app.py .
EXPOSE 8000
CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000"]
3、编写 Gateway 代码
创建文件:apps/gateway/app.py,这是 Gateway 核心业务代码。
# Gateway 服务入口:负责接收前端请求,并转发给 Data Service。

import os

import httpx
from fastapi import FastAPI, HTTPException
from fastapi.responses import JSONResponse


# 从环境变量读取 Data Service 地址。
# Docker Compose 网络中通常通过服务名 data-service 访问。
DATA_SERVICE_URL = os.getenv(
    "DATA_SERVICE_URL",
    "http://data-service:8000",
)


# 创建 FastAPI 应用实例。
app = FastAPI(title="fincross-risk Gateway")


# 转发 Data Service 的响应,并保留下游返回的状态码。
def forward_response(response: httpx.Response):
    try:
        # Data Service 应返回 JSON 格式的数据。
        content = response.json()
    except ValueError:
        # 下游返回非 JSON 内容时,说明响应格式异常。
        raise HTTPException(
            status_code=502,
            detail="invalid JSON from data service",
        )

    # 保留 404、409、422、503 等下游状态码,
    # 避免 Gateway 把失败请求误返回为成功。
    return JSONResponse(
        status_code=response.status_code,
        content=content,
    )


# Gateway 健康检查接口。
# 用于确认 Gateway 服务是否能够正常响应。
@app.get("/health")
def health():
    return {
        "service": "gateway",
        "status": "ok",
    }


# 提交交易。
# Gateway 接收前端数据,再转发给 Data Service 处理。
@app.post("/api/transactions")
async def create_transaction(payload: dict):
    try:
        # 使用异步 HTTP 客户端调用 Data Service。
        async with httpx.AsyncClient(timeout=15) as client:
            response = await client.post(
                f"{DATA_SERVICE_URL}/transactions",
                json=payload,
            )
    except httpx.HTTPError as exc:
        # 无法连接 Data Service 时,返回 503 错误。
        raise HTTPException(
            status_code=503,
            detail=f"data service unavailable: {exc}",
        )

    return forward_response(response)


# 查询交易。
# 前端通过 external_id 查询交易状态和风险分析结果。
@app.get("/api/transactions/{external_id}")
async def get_transaction(external_id: str):
    try:
        # 根据交易编号请求 Data Service。
        async with httpx.AsyncClient(timeout=15) as client:
            response = await client.get(
                f"{DATA_SERVICE_URL}/transactions/{external_id}",
            )
    except httpx.HTTPError as exc:
        # Data Service 不可用时,向前端返回 503 错误。
        raise HTTPException(
            status_code=503,
            detail=f"data service unavailable: {exc}",
        )

    return forward_response(response)
这样 C 区就写完了。
4、构建镜像
因为 Data Service 还没完成,所以这里先只构建镜像,等 Data Service 写完了再启动。
项目根目录使用以下命令进行构建。
docker compose build gateway
国内网络环境 Docker 和 Pip 可能报错,记得换一下国内源😶🌫️。
查看镜像构建是否成功。
docker image ls
(.venv) PS C:\Users\Ezekielx\PycharmProjects\fincross-risk> docker image ls
                                                                                                                                                                                    i Info →   U  In Use
IMAGE                          ID             DISK USAGE   CONTENT SIZE   EXTRA
apache/kafka:4.3.1             77e3df905404        686MB          239MB    U
fincross-risk-gateway:latest   8c1444c4da57        258MB         62.2MB
postgres:18.6                  4ef4dbc939d6        650MB          168MB    U
redis:8.10.1                   298e5b3bc566        212MB         57.5MB    U
(.venv) PS C:\Users\Ezekielx\PycharmProjects\fincross-risk>
出现 fincross-risk-gateway 说明构建成功了🥰。
二、B 区 Data Service
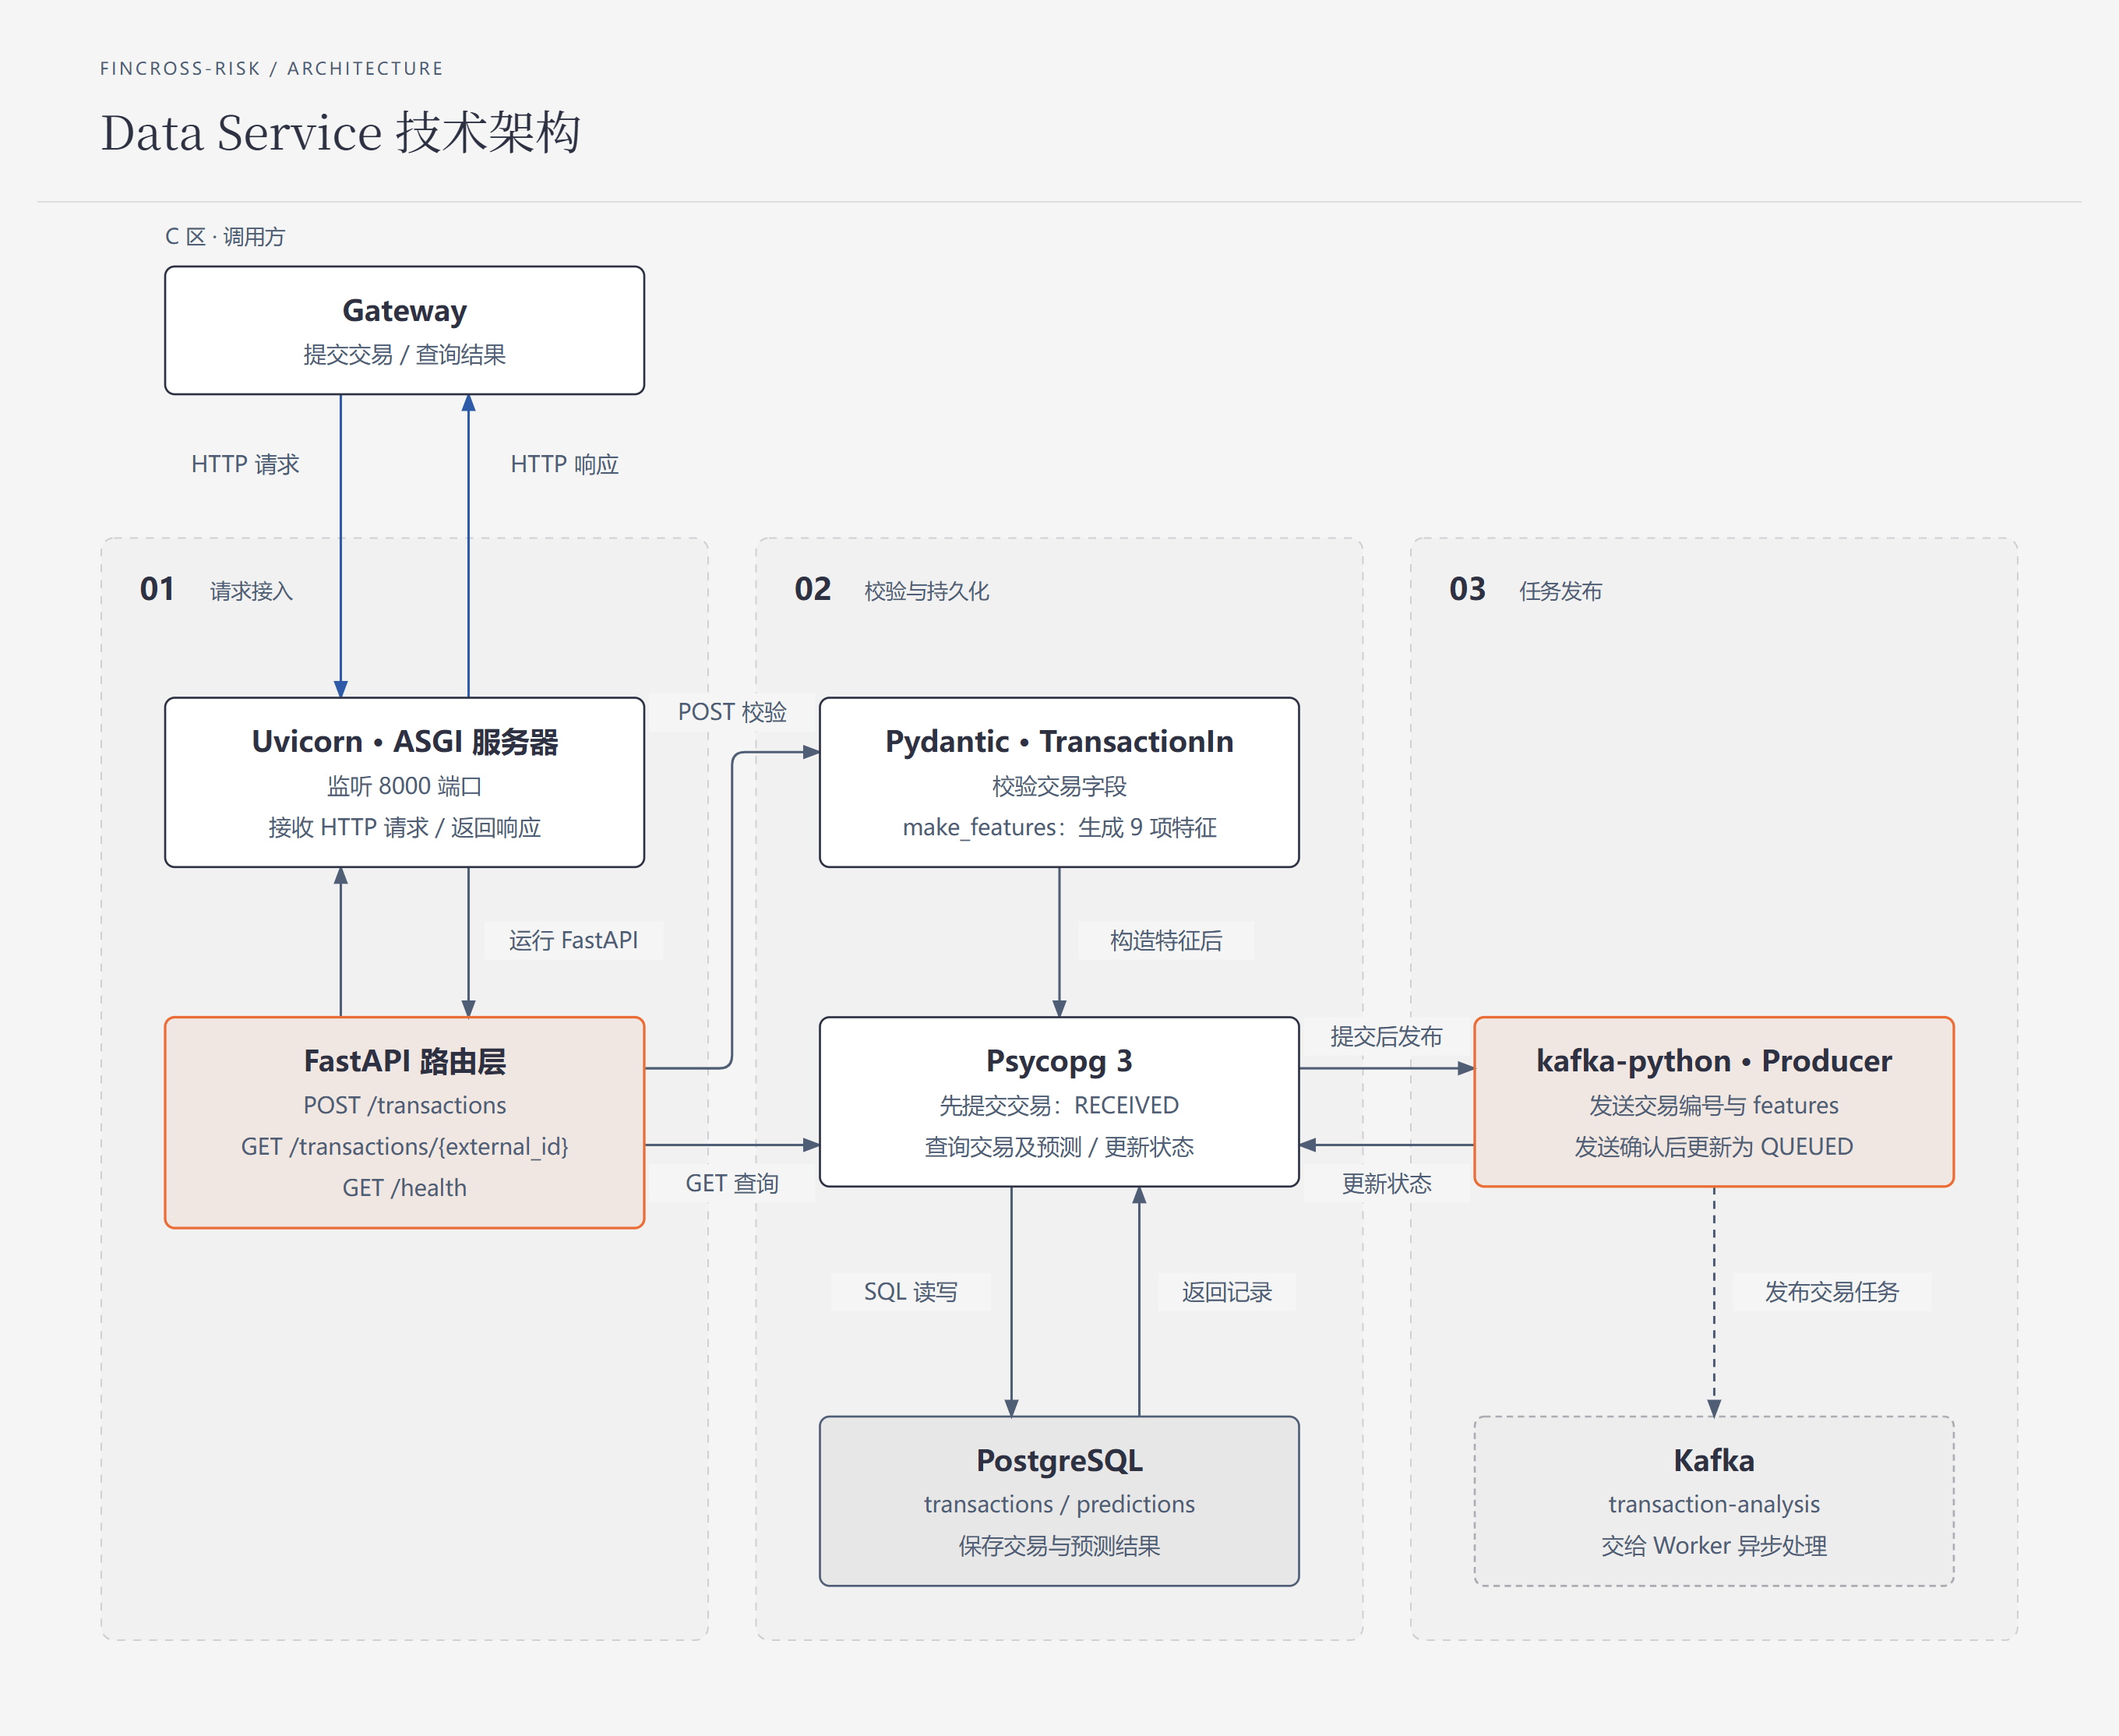
B 区用于保存交易并发送异步任务,使用 FastAPI + Uvicorn 接收请求,使用 Pydantic 校验数据,使用 psycopg2-binary 操作 PostgreSQL,使用 kafka-python 把交易任务发送到 Kafka。
1、创建依赖文件 requirements.txt
创建依赖清单文件:apps/data-service/requirements.txt,这是一份 Python 依赖清单,在后续使用 Docker 镜像构建命令时,对应服务的 Dockerfile 会自动读取依赖清单并安装依赖。
fastapi
uvicorn[standard]
psycopg[binary]
kafka-python
pydantic
| 依赖 | 作用 | 本章如何使用 |
|---|---|---|
fastapi |
定义交易提交和查询 API | 接收 Gateway 转发的 JSON |
uvicorn[standard] |
启动 FastAPI | 让 Data Service 在容器内监听 8000 |
psycopg[binary] |
PostgreSQL 驱动 | 执行插入、查询和状态更新 SQL |
kafka-python |
Kafka 客户端 | 把交易特征发送到任务主题 |
pydantic |
数据模型和字段校验 | 检查交易请求格式,减少脏数据进入数据库 |
2、创建镜像构建文件 Dockerfile
创建镜像构建文件:apps/data-service/Dockerfile,这一份的镜像构建指令清单,列出构建 Docker 镜像所需的每一步,由 docker build 读取并逐条执行。
FROM python:3.12-slim
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY app.py .
EXPOSE 8000
CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000"]
3、编写 Data Service 代码
创建文件:apps/data-service/app.py,这是 Data Service 核心业务代码。
import json
import math
import os
from datetime import datetime

import psycopg
from fastapi import FastAPI, HTTPException
from kafka import KafkaProducer
from pydantic import BaseModel

# 配置 PostgreSQL 和 Kafka。
DATABASE_URL = os.environ["DATABASE_URL"]
KAFKA_SERVERS = os.getenv("KAFKA_BOOTSTRAP_SERVERS", "kafka:19092")
KAFKA_TOPIC = os.getenv("KAFKA_TOPIC", "transaction-analysis")

# 支付方式编码,与训练脚本保持一致。
PAYMENT_FORMAT_CODES = {
    "ACH": 1,
    "CREDIT CARD": 2,
    "CHEQUE": 3,
    "CASH": 4,
    "WIRE": 5,
}

# 创建 FastAPI 应用。
app = FastAPI(title="fincross-risk Data Service")

# 创建 Kafka 生产者。
producer = KafkaProducer(
    bootstrap_servers=KAFKA_SERVERS,
    # 将任务序列化为 JSON 字节。
    value_serializer=lambda value: json.dumps(value).encode("utf-8"),
)

# 定义交易请求模型。
class TransactionIn(BaseModel):
    external_id: str
    transaction_timestamp: datetime
    from_bank: str
    from_account: str
    to_bank: str
    to_account: str
    amount_received: float
    receiving_currency: str
    amount_paid: float
    payment_currency: str
    payment_format: str
    # 可选的真实标签。
    is_laundering: bool | None = None

# 创建数据库连接。
def db():
    return psycopg.connect(DATABASE_URL)

# 将支付方式转换为数值编码,未知方式记为 0。
def payment_format_code(value: str) -> float:
    return float(PAYMENT_FORMAT_CODES.get(value.strip().upper(), 0))

# 生成交易特征。
def make_features(item: TransactionIn) -> dict:
    # 提取交易小时和星期。
    hour = item.transaction_timestamp.hour
    weekday = item.transaction_timestamp.weekday()
    return {
        # 保留原始金额,并计算非负金额的对数特征。
        "amount_paid": float(item.amount_paid),
        "amount_received": float(item.amount_received),
        "amount_paid_log": math.log1p(max(item.amount_paid, 0.0)),
        "amount_received_log": math.log1p(max(item.amount_received, 0.0)),
        "hour": float(hour),
        "weekday": float(weekday),
        # 生成跨行和跨币种标记。
        "cross_bank_flag": float(item.from_bank != item.to_bank),
        "cross_currency_flag": float(
            item.payment_currency.strip().upper()
            != item.receiving_currency.strip().upper()
        ),
        "payment_format_code": payment_format_code(item.payment_format),
    }

# Data Service 健康检查。
@app.get("/health")
def health():
    with db() as conn:
        with conn.cursor() as cur:
            cur.execute("SELECT 1")
            cur.fetchone()
    return {"service": "data-service", "status": "ok"}

# 提交交易。
@app.post("/transactions")
def create_transaction(item: TransactionIn):
    features = make_features(item)
    # 保存交易,初始状态为 RECEIVED。
    try:
        with db() as conn:
            with conn.cursor() as cur:
                cur.execute(
                    """INSERT INTO transactions
                    (external_id, source_type, transaction_timestamp,
                     from_bank, from_account, to_bank, to_account,
                     amount_received, receiving_currency, amount_paid,
                     payment_currency, payment_format, is_laundering, status)
                    VALUES (%s, 'ONLINE', %s, %s, %s, %s, %s, %s, %s,
                            %s, %s, %s, %s, 'RECEIVED')
                    RETURNING id""",
                    (
                        item.external_id,
                        item.transaction_timestamp,
                        item.from_bank,
                        item.from_account,
                        item.to_bank,
                        item.to_account,
                        item.amount_received,
                        item.receiving_currency,
                        item.amount_paid,
                        item.payment_currency,
                        item.payment_format,
                        item.is_laundering,
                    ),
                )
                # 获取内部交易编号并提交事务。
                transaction_id = cur.fetchone()[0]
                conn.commit()
    except psycopg.errors.UniqueViolation:
        # 交易编号重复时返回 409。
        raise HTTPException(status_code=409, detail="external_id already exists")

    # 组装交易分析任务。
    message = {
        "transaction_id": transaction_id,
        "external_id": item.external_id,
        "features": features,
    }
    try:
        # 发布任务并等待 Kafka 确认。
        producer.send(KAFKA_TOPIC, message).get(timeout=10)
    except Exception as exc:
        # Kafka 发布失败时返回 503。
        raise HTTPException(status_code=503, detail=f"kafka publish failed: {exc}")

    # 将 RECEIVED 更新为 QUEUED,避免覆盖已完成状态。
    with db() as conn:
        with conn.cursor() as cur:
            cur.execute(
                "UPDATE transactions SET status='QUEUED' WHERE id=%s AND status='RECEIVED'",
                (transaction_id,),
            )
            conn.commit()
    # 返回任务受理信息。
    return {
        "external_id": item.external_id,
        "transaction_id": transaction_id,
        "status": "QUEUED",
    }

# 查询交易。
@app.get("/transactions/{external_id}")
def get_transaction(external_id: str):
    # 查询交易和最新预测,尚未预测的交易也保留。
    with db() as conn:
        with conn.cursor() as cur:
            cur.execute(
                """SELECT t.external_id, t.transaction_timestamp,
                          t.from_bank, t.from_account, t.to_bank, t.to_account,
                          t.amount_received, t.receiving_currency,
                          t.amount_paid, t.payment_currency, t.payment_format,
                          t.is_laundering, t.status,
                          p.risk_probability, p.risk_level,
                          p.model_version, p.predicted_at
                   FROM transactions t
                   LEFT JOIN LATERAL (
                       SELECT * FROM predictions p0
                       WHERE p0.transaction_id=t.id
                       ORDER BY p0.predicted_at DESC LIMIT 1
                   ) p ON TRUE
                   WHERE t.external_id=%s""",
                (external_id,),
            )
            row = cur.fetchone()
    if row is None:
        # 交易不存在时返回 404。
        raise HTTPException(status_code=404, detail="transaction not found")
    # 按查询字段顺序组装响应字典。
    keys = [
        "external_id", "transaction_timestamp", "from_bank", "from_account",
        "to_bank", "to_account", "amount_received", "receiving_currency",
        "amount_paid", "payment_currency", "payment_format", "is_laundering",
        "status", "risk_probability", "risk_level", "model_version",
        "predicted_at",
    ]
    return dict(zip(keys, row))
4、构建镜像
项目根目录使用以下命令进行构建并启动。
docker compose build data-service
docker compose up -d data-service
查看容器是否启动。
(.venv) PS C:\Users\Ezekielx\PycharmProjects\fincross-risk> docker ps
CONTAINER ID   IMAGE                        COMMAND                   CREATED         STATUS                    PORTS                      NAMES
fdb6ebe2177a   fincross-risk-data-service   "uvicorn app:app --h…"   8 seconds ago   Up 6 seconds (healthy)    127.0.0.1:8001->8000/tcp   fincross-data-service
4be8212e7fc4   postgres:18.6                "docker-entrypoint.s…"   4 days ago      Up 24 minutes (healthy)   127.0.0.1:5432->5432/tcp   fincross-postgres
82d1657de82e   redis:8.10.1                 "docker-entrypoint.s…"   4 days ago      Up 24 minutes (healthy)   6379/tcp                   fincross-redis
ce11e5f44bbf   apache/kafka:4.3.1           "/__cacert_entrypoin…"   4 days ago      Up 24 minutes (healthy)   127.0.0.1:9092->9092/tcp   fincross-kafka
(.venv) PS C:\Users\Ezekielx\PycharmProjects\fincross-risk>
fincross-data-service 状态为 healthy 就说明成功了😋。
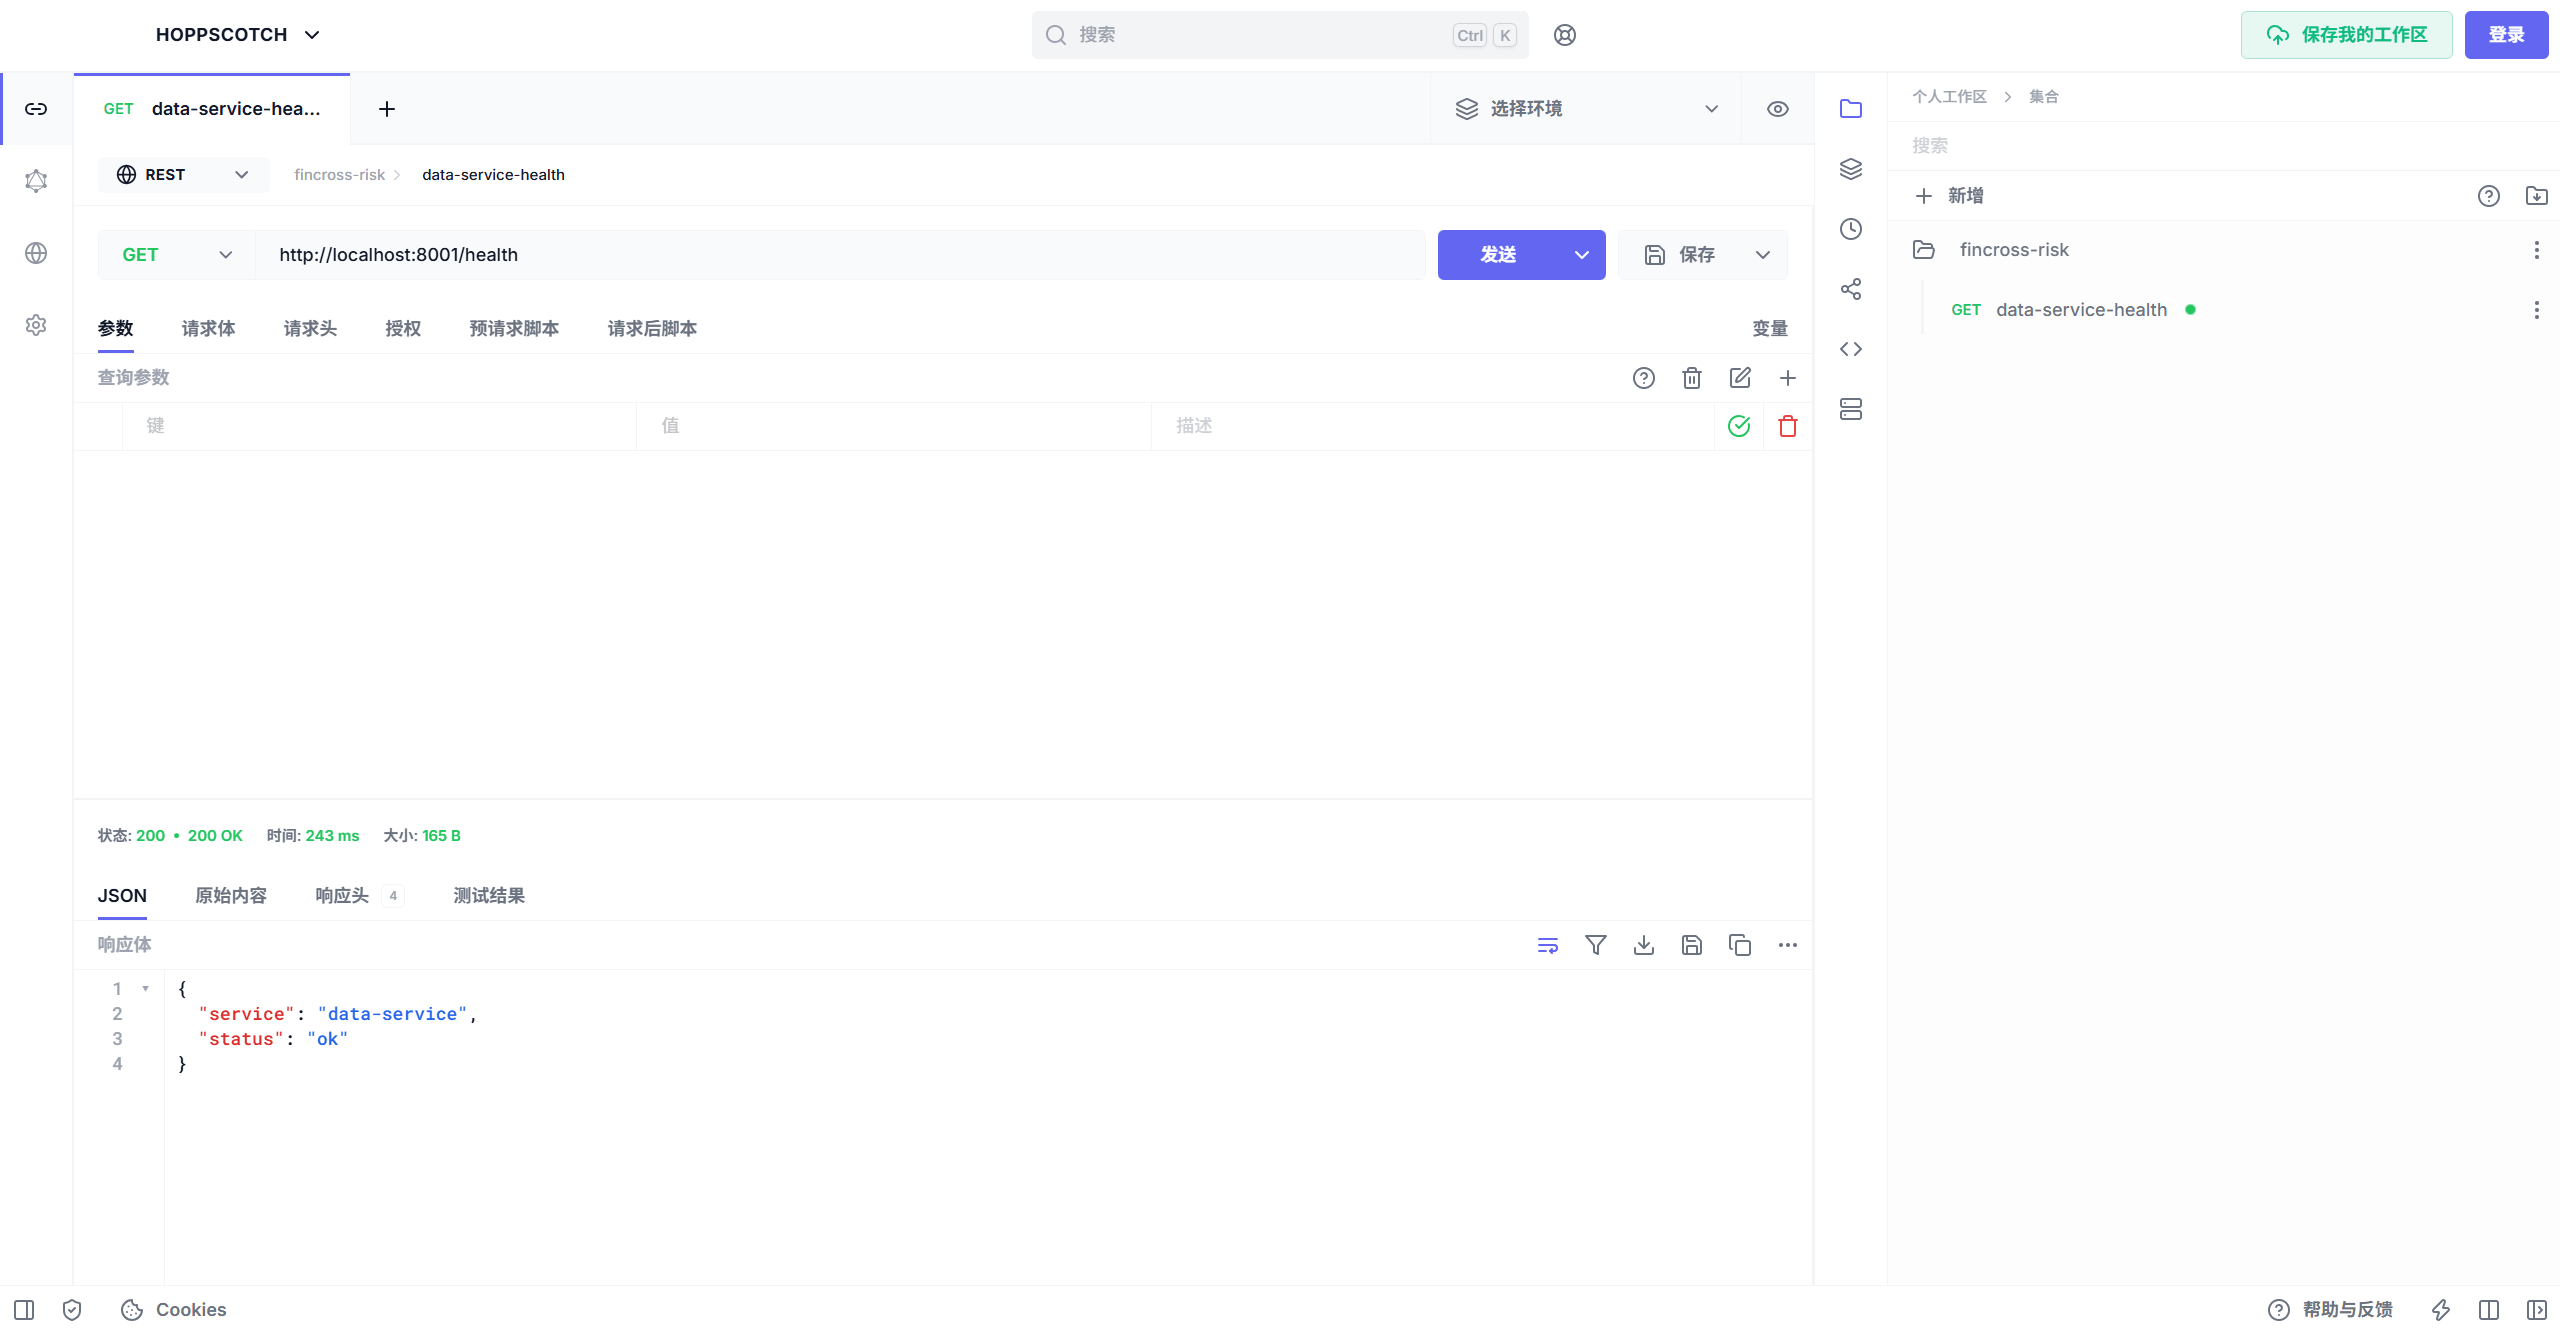
下面测试健康状态检查接口是否可以使用,使用任意发起 HTTP 请求的工具(Postman 这种,浏览器都行,我用的 Hoppscotch)访问 http://localhost:8001/health。
返回以下结果说明成功了。
{
  "service": "data-service",
  "status": "ok"
}
三、机器学习与模型服务的基本原理
假设要判断一笔交易是否值得关注。传统程序可以由人为编写规则:“金额超过某个值,并且跨行,就标记高风险。”条件和阈值都是人为指定的。
机器学习则是给算法一批案例,让它根据输入与已知结果之间的关系,调整内部参数,再对新交易作出预测。
1、准备模型服务输入
假设收到一笔交易:周六凌晨 2 点,从 A 银行转到 B 银行,支付和接收金额都是 9000,币种相同,支付方式为 WIRE。
“银行名称”、“支付方式”等业务信息不能直接拿来加减乘除。本项目先由 Data Service 的 make_features() 把交易整理成 9 个数。每个数描述交易的一个方面,叫作一个特征。
假设有一笔交易:周六凌晨 2 点,从 A 银行向 B 银行电汇(WIRE)9000 元,到账也是 9000 元,币种相同。
模型根据金额、时间、是否跨行等信息判断风险。这些供模型参考的信息叫作特征。本项目使用以下 9 个特征,由 Data Service 的 make_features() 函数准备:
| 特征 | 含义 | 值 | 取值方法 |
|---|---|---|---|
amount_paid |
支付金额 | 9000 | 直接取支付金额 |
amount_received |
接收金额 | 9000 | 直接取接收金额 |
amount_paid_log |
支付金额的对数 | 约 9.105 | x_{\log}=\ln\left(1+\max(x,0)\right),其中 $x$ 为支付金额 |
amount_received_log |
接收金额的对数 | 约 9.105 | x_{\log}=\ln\left(1+\max(x,0)\right),其中 $x$ 为接收金额 |
hour |
小时 | 2 | 从交易时间中提取小时 |
weekday |
星期 | 5 | 从交易时间中提取,周一为 0,依次递增至周日为 6 |
cross_bank_flag |
是否跨行 | 1 | 转出银行与接收银行不同为 1,相同为 0 |
cross_currency_flag |
是否跨币种 | 0 | 支付币种与接收币种不同为 1,相同为 0 |
payment_format_code |
支付方式 | 5 | 按固定规则编码:ACH 为 1;CREDIT CARD 为 2;CHEQUE 为 3;CASH 为 4;WIRE 为 5;REINVESTMENT 为 6;BITCOIN 为 7;未知支付方式为 0 |
金额取对数,是为了缩小金额之间的数值差距。计算方式是:
x 是原金额:负数先按 0 处理,再加 1、取自然对数。本例为 \ln(9001)\approx9.105。
Worker 将表中的特征名称和数值通过 JSON 发给 Model Service。
2、模型服务输入处理
Model Service 接受到输入后,会使用接口中的代码:
row = [[float(payload[name]) for name in FEATURE_NAMES]]
会按 FEATURE_NAMES 的顺序取值,把值转成数值类型。比如上述例子中的输入将会转换成:
# 模型接口接收的是“一批交易”,外层放多笔交易,内层放一笔交易的 9 个特征,这里一批交易中只有一笔交易。
row = [[9000, 9000, 9.105, 9.105, 2, 5, 1, 0, 5]]
到这里,输入的数据从带字段名的 JSON 变成顺序固定的一行数字,而下一行的代码:
probability = float(model.predict_proba(row)[0][1])
将会使用 predict_proba() 函数来计算这笔交易的风险概率。
3、风险概率计算
前面已经把一笔交易整理成 9 个数。接下来,模型会用自己训练好的规则处理这 9 个数,得到风险概率。
本项目会比较三种模型:逻辑回归、随机森林和 XGBoost。训练结束后只选其中一个保存为 model.pkl 供 Model Service 调用。
逻辑回归
逻辑回归给每个特征一个权重。它先把“特征 × 权重”全部加起来:
- x_1,\ldots,x_9:这笔交易的 9 个特征值;
- w_1,\ldots,w_9:模型训练出来的 9 个权重;
- b:基础偏移量;
- z:加权后得到的分数。
本例只让支付金额、支付金额的对数、是否跨行这三个特征的权重非零,其余六个权重为零。代入后:
z 还不是概率,因为它可以小于 0,也可以大于 1。于是模型再用 Sigmoid 把它压到 0 和 1 之间:
代入 z=1.121:
所以这次预测得到的风险概率约为 75.4%。
随机森林
决策树不做上面的加权求和,而是把判断写成一连串问题:
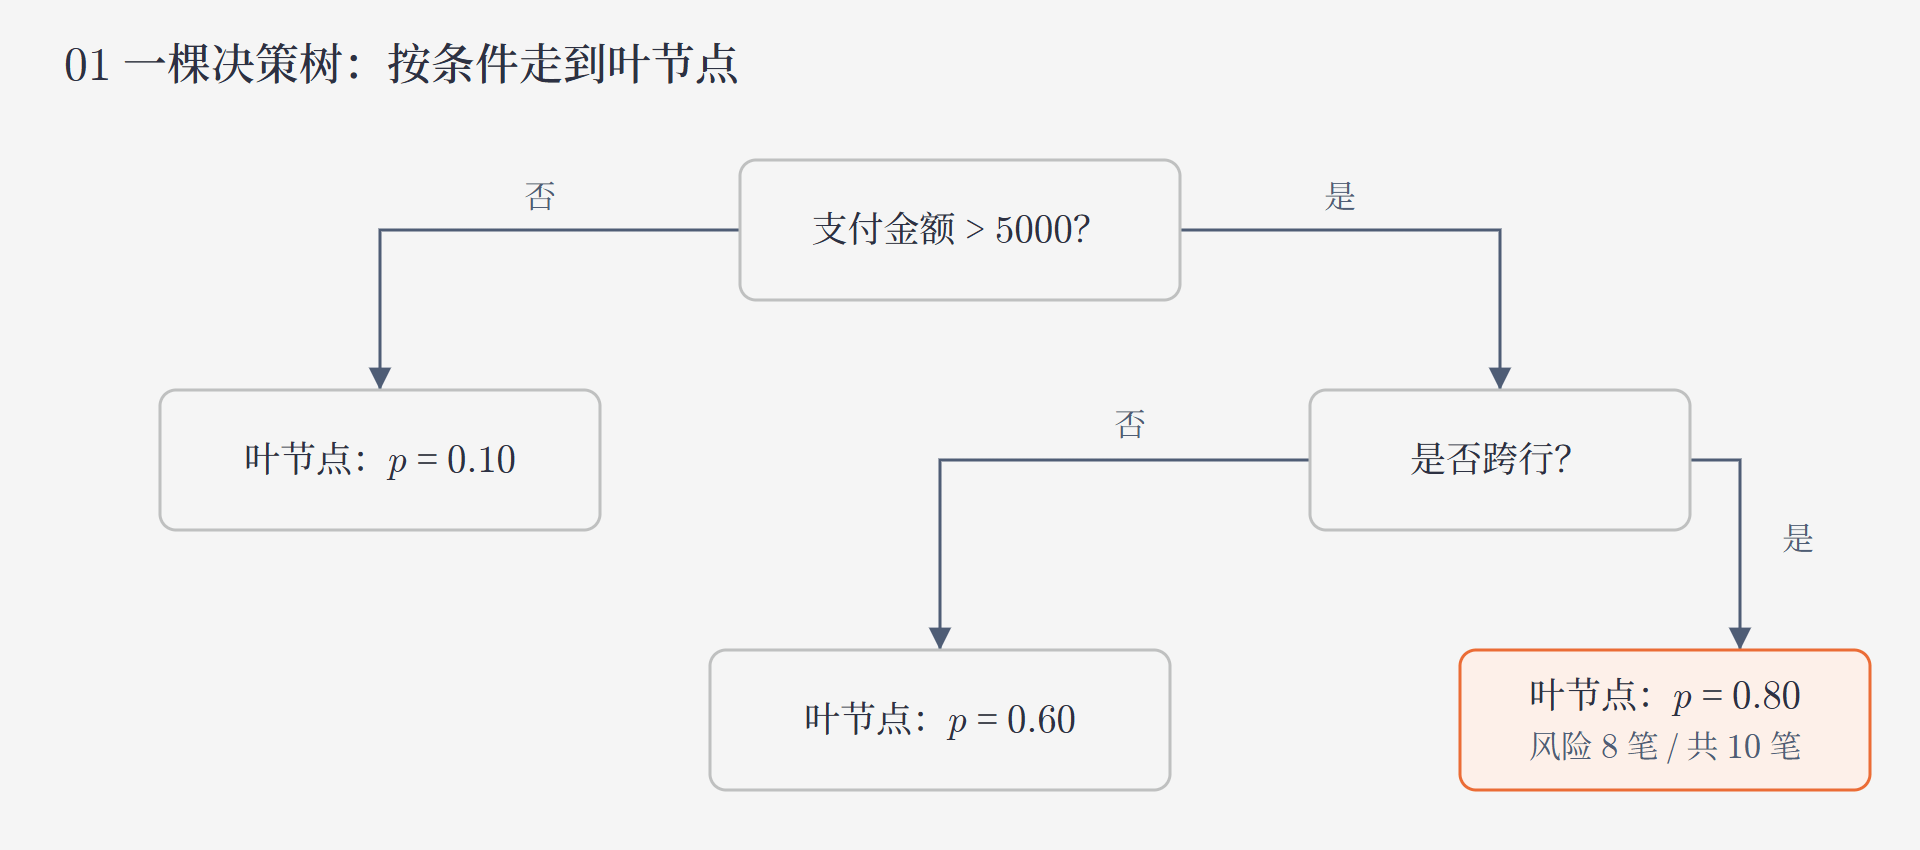
这笔交易的金额是 9000,大于 5000,先走“是”;它又是跨行交易,再走“是”,到达右下角的叶节点。
预测时不会再去查历史交易,而是读取这个叶节点在训练时所占的类别比例。不考虑样本权重时,如果这里的 10 笔训练交易中有 8 笔是风险交易,它给出的风险概率就是:
问题中的阈值和叶节点的比例,都是训练时确定的,新交易只需沿着树走一遍,就能得到结果。
单棵树容易受训练样本影响。随机森林通过抽取不同样本、在分叉时考虑不同特征,训练出多棵不一样的树;预测时让同一笔交易分别通过它们。
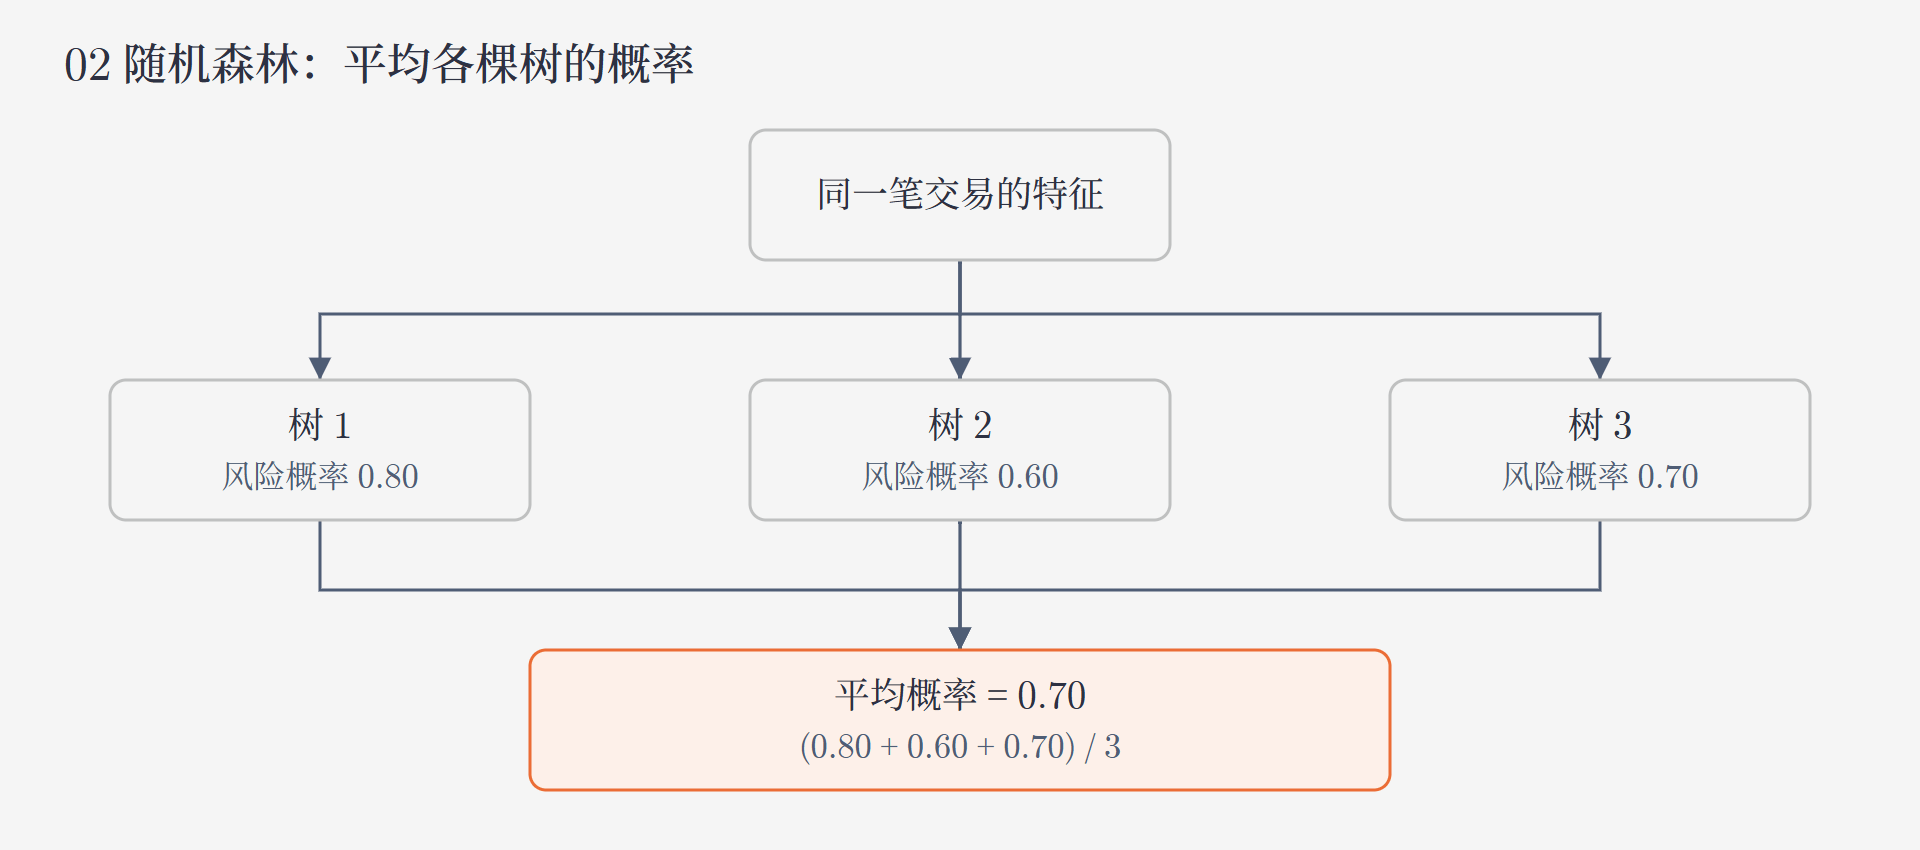
图中三棵树给出的概率是 0.8、0.6、0.7,随机森林取平均:
图中三棵树给出的概率是 0.8、0.6、0.7,随机森林取平均:
本项目使用 150 棵树,最后对各树的风险概率取平均。训练时启用 class_weight='balanced',让数量少的那类交易获得更大权重。
假设训练数据有 900 笔正常交易、100 笔风险交易。
如果不加权,每笔交易都算 1 份。模型即使将所有交易都判为正常,准确率也有 900/1000=90\%,但风险交易全部漏报。看似准确率很高,实际上没有识别出任何风险。
启用 balanced 后,可以将正常交易和风险交易的相对权重理解为每笔分别算 1 份和 9 份,两类总权重都是 900。仍然全部判为正常时,准确率则变成了 900/1800=50\%,显著降低了准确率。
XGBoost
XGBoost 逐棵训练新树,根据当前预测与真实结果的差距,改进整体预测。真实结果记为 y(风险为 1,正常为 0),预测的风险概率记为 p。例如:
- 风险交易只预测出 20% 的概率,y-p=1-0.2=+0.8,需要提高分数;
- 正常交易却预测出 70% 的概率,y-p=0-0.7=-0.7,需要降低分数。
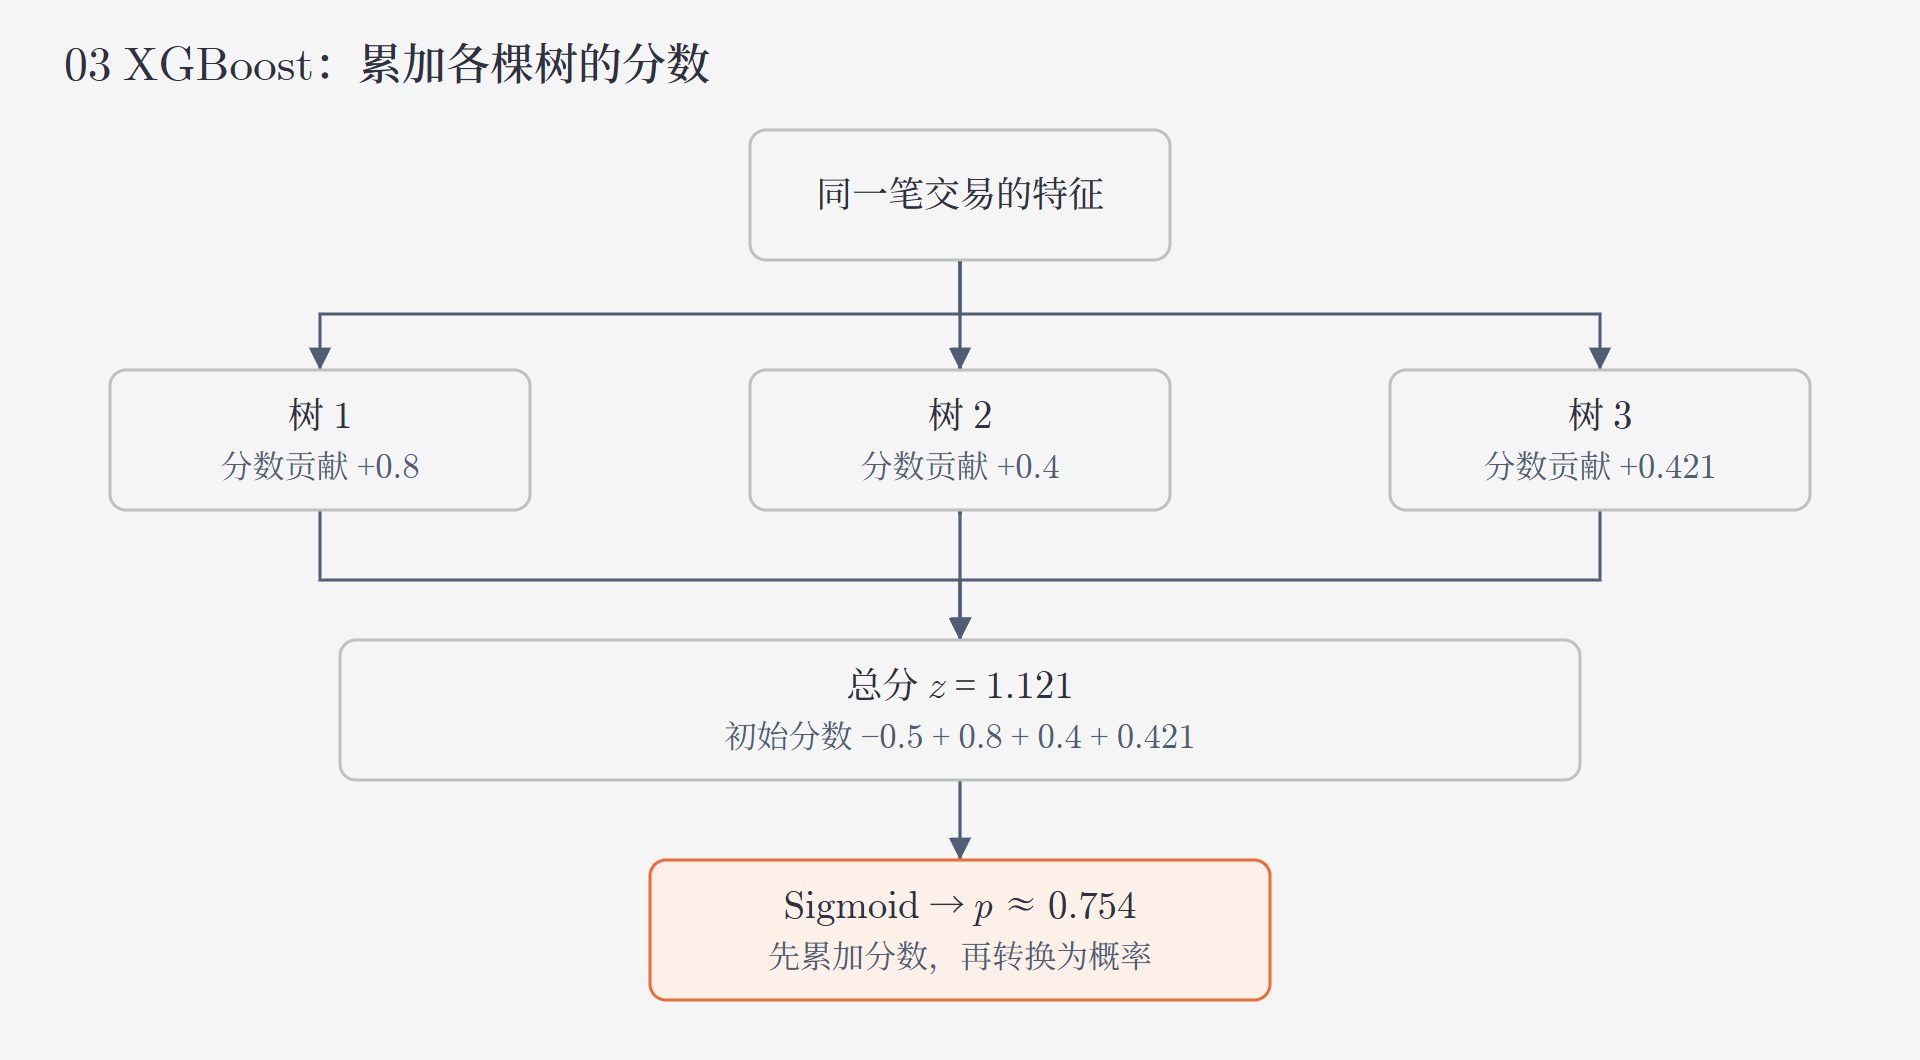
新树根据金额、时间等特征将交易分到不同叶节点,再根据每个叶节点中训练样本的预测偏差,计算一个调整分数。**它不修改旧树,而是把新树给出的分数加到原有总分上。**例如,一笔交易原来的总分是 0.5:
- 新树给出 +0.3,总分变为 0.5+0.3=0.8,转换后的风险概率上升;
- 新树给出 -0.3,总分变为 0.5-0.3=0.2,转换后的风险概率下降。
训练完成后,树的规则便固定了。预测时,同一笔交易分别经过各棵树,取出对应叶节点的分数,与初始分数相加,再通过 Sigmoid 转为风险概率。
设初始分数为 b,各棵树给出的分数为 c_1,c_2,\ldots,c_T(已包含学习率的缩放),T 是树的数量:
所有树完成后,再统一用 Sigmoid 转成概率:
4、模型训练
训练脚本用 joblib 保存选中的模型,Model Service 启动时再加载它:
# 训练结束后保存
joblib.dump(models[best_name], MODEL_DIR / 'model.pkl')

# 服务启动时加载
model = joblib.load(MODEL_PATH)
文件中保存的是学好的权重、树结构等内容。加载后,服务就可以调用 model.predict_proba() 处理新交易。
各个依赖的作用如下:
| 组件 | 作用 |
|---|---|
| NumPy | 处理数值数据,例如计算金额对数 |
| scikit-learn | 提供逻辑回归、随机森林等模型 |
| XGBoost | 提供 XGBoost 模型 |
| joblib | 保存和加载模型 |
| FastAPI + Uvicorn | 接收 HTTP 请求,调用模型并返回结果 |
5、模型服务结果输出
假设模型返回:
model.predict_proba(row)
# [[0.246, 0.754]]
#   正常    风险
返回结果中,0.246 是正常概率,0.754 是风险概率。取出风险概率的过程为:
result = model.predict_proba(row)  # 得到 [[0.246, 0.754]]
first = result[0]                 # 取出第一笔交易的结果:[0.246, 0.754]
probability = float(first[1])     # 取第二个数 0.754,并转为普通浮点数
接口源代码将这些操作合为一行代码:
probability = float(model.predict_proba(row)[0][1])
服务再按阈值分级:
本例属于高风险,返回:
{
  "risk_probability": 0.754,
  "risk_level": "HIGH",
  "model_version": "aml-model-v1"
}
Worker 收到结果后,再将其写回数据库。
四、A 区 Model Service
使用 FastAPI + Uvicorn 暴露 /predict 接口,使用 joblib 加载训练好的 scikit-learn 或 XGBoost 模型,接收 Worker 的特征 JSON 后返回风险分数和风险等级。
1、创建依赖文件 requirements.txt
创建依赖清单文件:apps/model-service/requirements.txt,这是一份 Python 依赖清单,在后续使用 Docker 镜像构建命令时,对应服务的 Dockerfile 会自动读取依赖清单并安装依赖。
fastapi
uvicorn[standard]
scikit-learn
xgboost
joblib
numpy
| 依赖 | 作用 | 具体用途 |
|---|---|---|
fastapi |
提供预测 HTTP 接口 | 定义 /health 和 /predict |
uvicorn[standard] |
启动接口服务 | 让 Model Service 监听 8000 |
scikit-learn |
提供机器学习算法、预处理与评估工具 | 训练阶段建立逻辑回归、随机森林等模型;推理阶段提供这些模型及 Pipeline 的类实现 |
xgboost |
提供梯度提升树算法及模型实现 | 使用 XGBClassifier 训练模型;加载和运行训练好的 XGBoost 模型也需要此依赖 |
joblib |
保存、恢复 Python 模型对象 | joblib.dump() 保存模型;joblib.load() 从 models/model.pkl 加载模型 |
numpy |
数值数组与数学运算基础库 | 训练时用 np.log1p 计算金额对数;预测时接口传入二维列表,由模型库处理数组转换 |
2、创建镜像构建文件 Dockerfile
创建镜像构建文件:apps/model-service/Dockerfile,这一份的镜像构建指令清单,列出构建 Docker 镜像所需的每一步,由 docker build 读取并逐条执行。
FROM python:3.12-slim
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY app.py .
EXPOSE 8000
CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000"]
3、编写 Model Service 代码
创建文件:apps/model-service/app.py,这是 Model Service 核心业务代码。
import os
from pathlib import Path

# 加载模型,创建接口并返回 HTTP 错误
import joblib
from fastapi import FastAPI, HTTPException

# 固定九个特征的排列顺序,与训练时一致
FEATURE_NAMES = [
    "amount_paid", "amount_received", "amount_paid_log",
    "amount_received_log", "hour", "weekday", "cross_bank_flag",
    "cross_currency_flag", "payment_format_code",
]

# 读取环境变量;未设置时使用默认值
MODEL_PATH = os.getenv("MODEL_PATH", "/models/model.pkl")
MODEL_VERSION = os.getenv("MODEL_VERSION", "aml-model-v1")

# 创建模型服务的 API 应用
app = FastAPI(title="fincross-risk Model Service")

# 启动时加载一次模型;文件不存在时暂记为 None
model = joblib.load(MODEL_PATH) if Path(MODEL_PATH).exists() else None

# 健康检查接口,供外部判断模型服务是否就绪
@app.get("/health")
def health():
    # 模型未加载时返回 503,表示服务尚不可用
    if model is None:
        raise HTTPException(status_code=503, detail="model is not loaded; train model first")

    # 模型已加载,返回服务状态和版本标识
    return {
        "service": "model-service",
        "status": "ok",
        "loaded": model is not None,
        "model_version": MODEL_VERSION,
    }

# 预测接口,payload 接收请求中的 JSON 特征数据
@app.post("/predict")
def predict(payload: dict):
    # 没有可用模型时拒绝预测
    if model is None:
        raise HTTPException(status_code=503, detail="model is not loaded; train model first")

    # 检查九个特征是否齐全,缺失时返回 400 和字段名
    missing = [name for name in FEATURE_NAMES if name not in payload]
    if missing:
        raise HTTPException(status_code=400, detail={"missing": missing})

    # 按训练时的顺序取值并转为浮点数,外层列表表示一批交易
    row = [[float(payload[name]) for name in FEATURE_NAMES]]

    # 计算概率;[0] 取第一笔交易,[1] 取风险类别的概率
    probability = float(model.predict_proba(row)[0][1])

    # 根据风险概率设定风险等级
    risk_level = "HIGH" if probability >= 0.70 else "MEDIUM" if probability >= 0.30 else "LOW"

    # 返回概率、等级和版本;数据库写回由 Worker 负责
    return {
        "risk_probability": probability,
        "risk_level": risk_level,
        "model_version": MODEL_VERSION,
    }
4、构建镜像
因为模型文件 models/model.pkl 现在还没有,所以这里先只构建镜像,等后面模型训练完了再启动。
项目根目录使用以下命令进行构建。
docker compose build model-service
查看镜像构建是否成功。
docker image ls
(.venv) PS C:\Users\Ezekielx\PycharmProjects\fincross-risk> docker image ls
                                                                                                                                                                                    i Info →   U  In Use
IMAGE                                ID             DISK USAGE   CONTENT SIZE   EXTRA
apache/kafka:4.3.1                   77e3df905404        686MB          239MB    U
fincross-risk-data-service:latest    c5381d7a71d9        291MB         68.8MB    U
fincross-risk-gateway:latest         8c1444c4da57        258MB         62.2MB
fincross-risk-model-service:latest   24048d1ba4e3       1.31GB          451MB
postgres:18.6                        4ef4dbc939d6        650MB          168MB    U
redis:8.10.1                         298e5b3bc566        212MB         57.5MB    U
(.venv) PS C:\Users\Ezekielx\PycharmProjects\fincross-risk>
出现 fincross-risk-model-service 说明构建成功了🥰。
五、A 区 Worker
使用 kafka-python 消费 Kafka 任务,使用 requests 通过 HTTP 调用 Model Service,使用 Psycopg 3 将评分结果写回 PostgreSQL;Worker 是常驻后台进程,不直接面对浏览器。
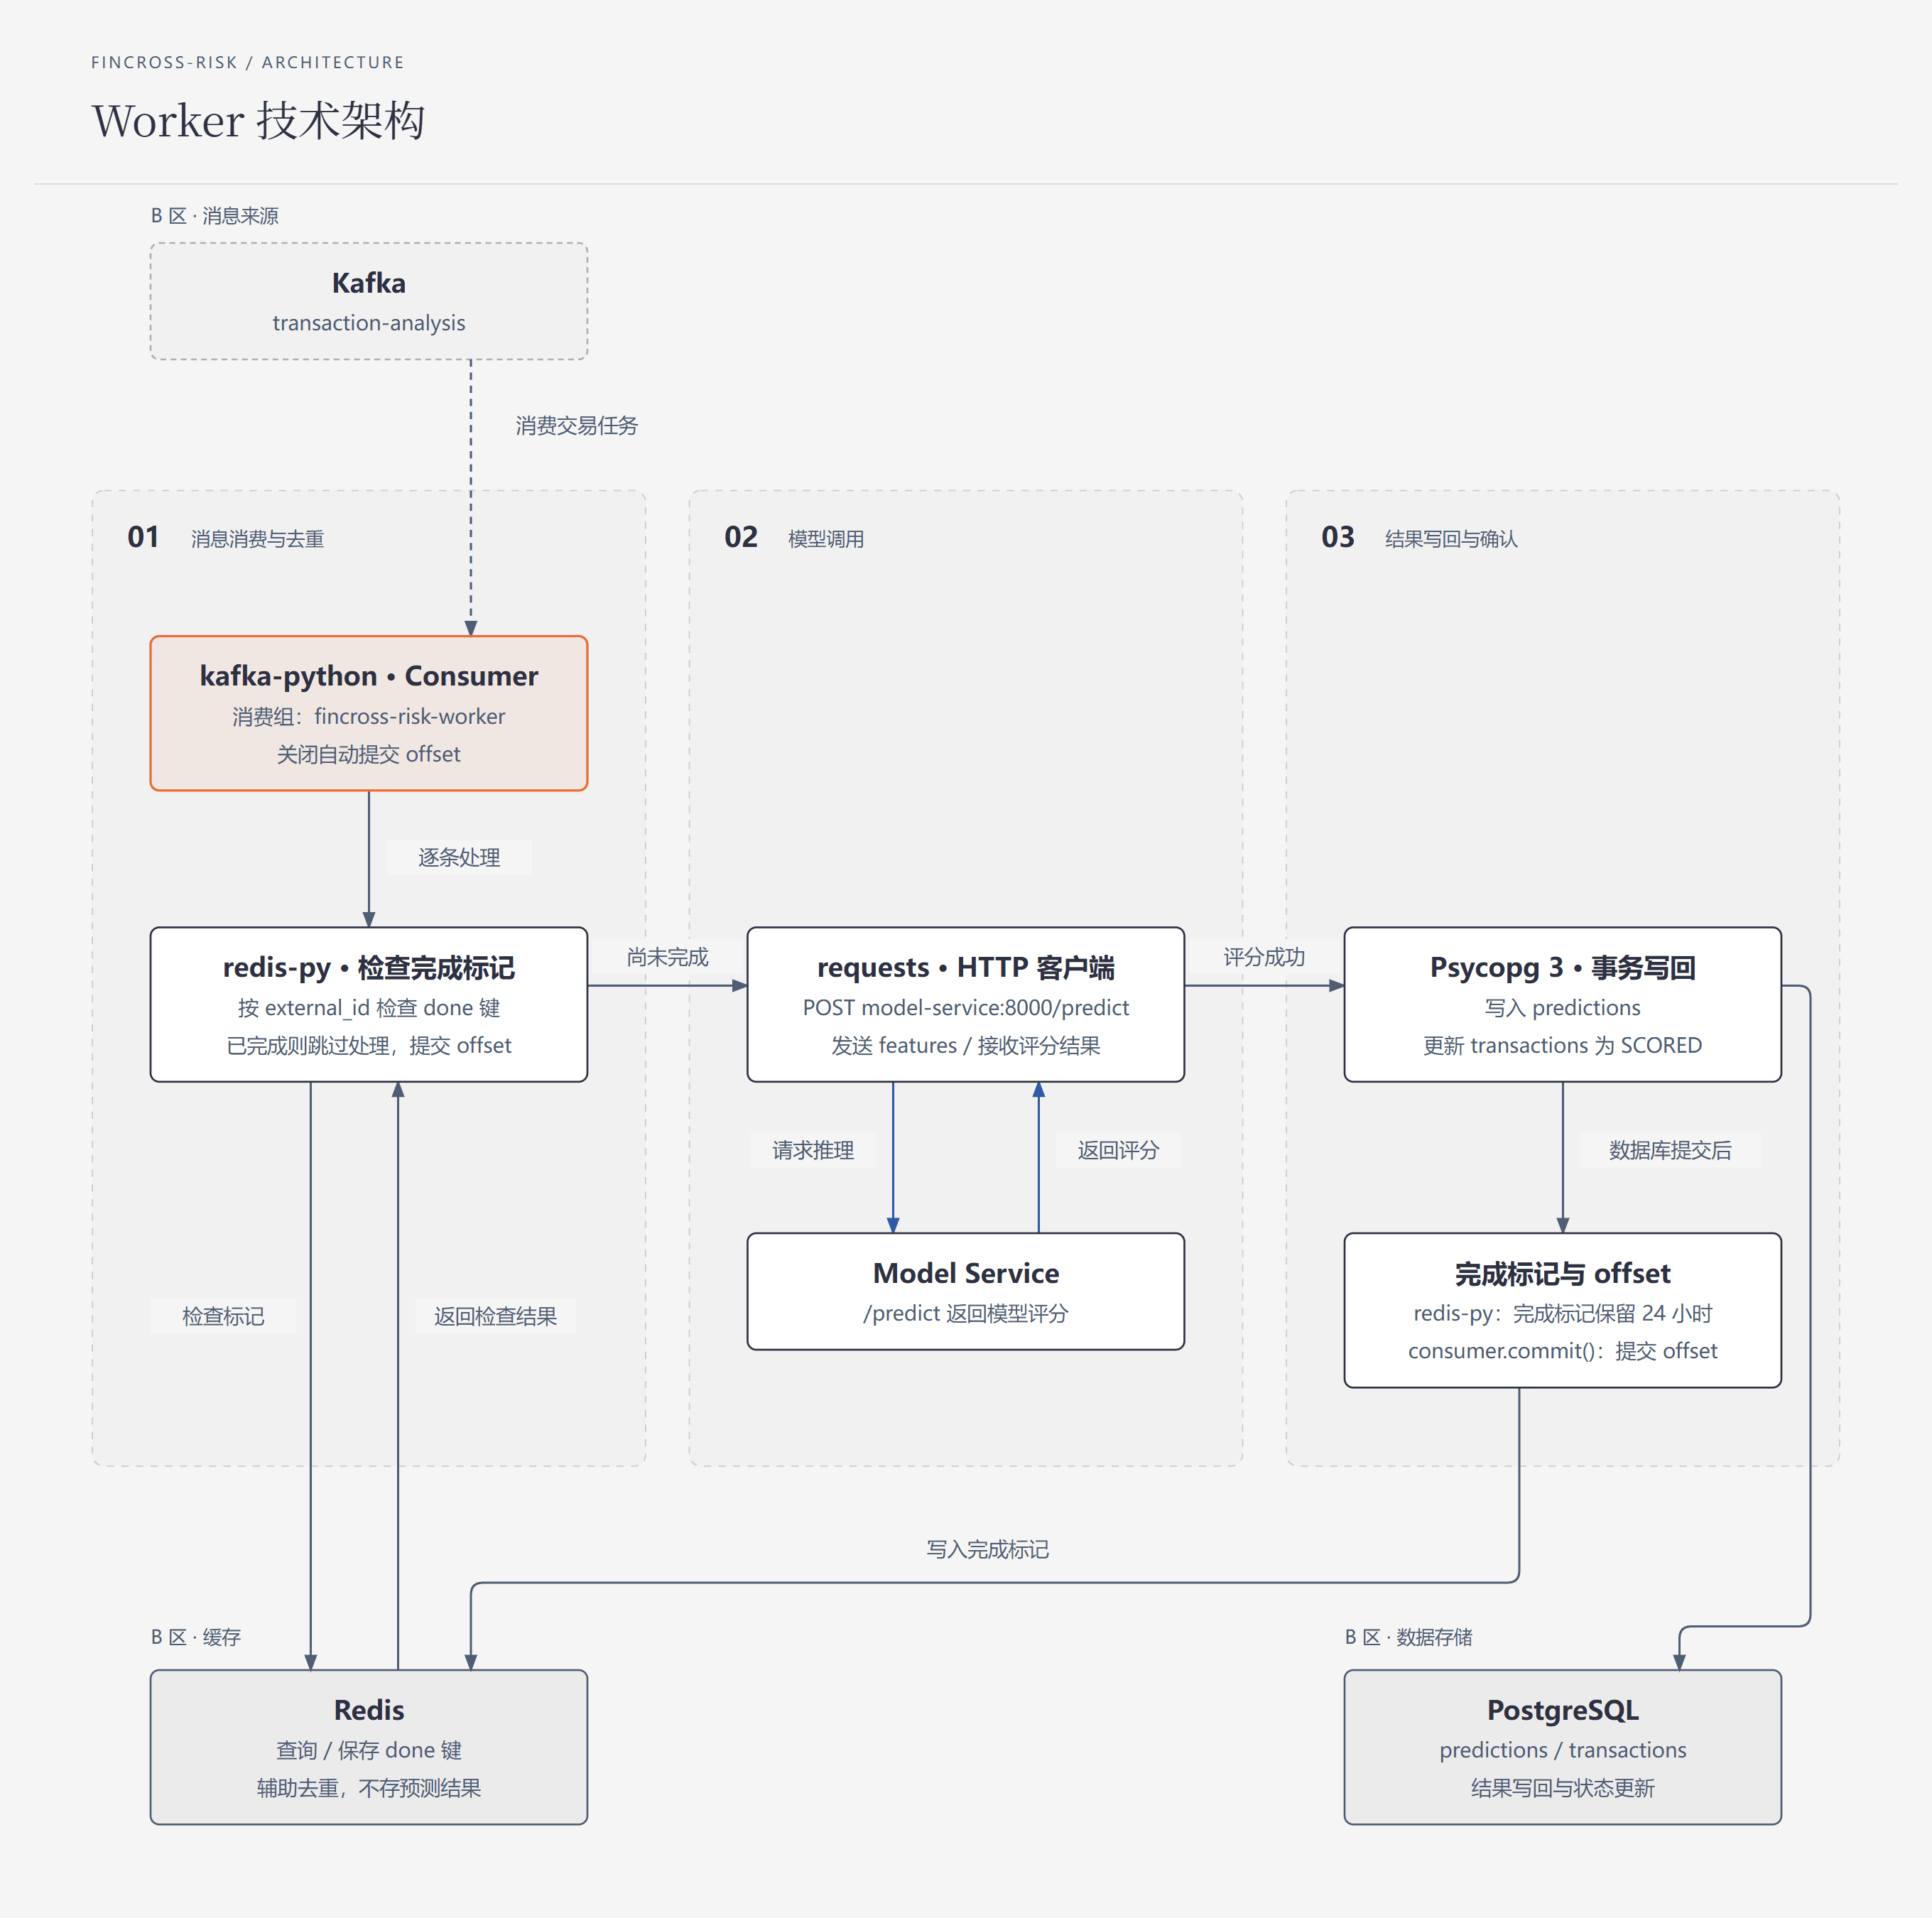
1、创建依赖文件 requirements.txt
创建依赖清单文件:apps/worker/requirements.txt,在后续构建 Docker 镜像时,Dockerfile 会读取这份清单并安装依赖。
requests
psycopg[binary]
kafka-python
redis
| 依赖 | 作用 |
|---|---|
requests |
HTTP 客户端。向 Model Service 的 /predict 接口发送交易特征,并读取返回的风险概率、风险等级和模型版本。 |
psycopg[binary] |
PostgreSQL 驱动。用于执行 SQL,将预测结果和交易状态写回数据库;[binary] 提供预编译组件,简化安装。 |
kafka-python |
Kafka 客户端。用于订阅交易分析主题、读取任务消息,并在处理成功后提交消费进度。 |
redis |
Redis 客户端。用于检查和保存任务完成标记,跳过已有完成标记的交易。 |
2、创建镜像构建文件 Dockerfile
创建镜像构建文件:apps/worker/Dockerfile,列出构建 Worker 镜像所需的步骤。
FROM python:3.12-slim
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY worker.py .
CMD ["python", "worker.py"]
3、编写 Worker 代码
创建文件:apps/worker/worker.py,这是 Worker 的核心业务代码。
每条任务按“读取消息 → 检查完成标记 → 请求模型预测 → 写入数据库 → 保存完成标记 → 提交消费进度”的顺序处理。预测结果和交易状态在同一个数据库事务中写入,保证这两项修改一起成功或一起回滚。
import json
import os
import time

import psycopg
import redis
import requests
from kafka import KafkaConsumer


# 读取数据库、Redis、Kafka 和模型服务的连接配置。
DATABASE_URL = os.environ["DATABASE_URL"]
REDIS_URL = os.getenv("REDIS_URL", "redis://redis:6379/0")
KAFKA_SERVERS = os.getenv("KAFKA_BOOTSTRAP_SERVERS", "kafka:19092")
KAFKA_TOPIC = os.getenv("KAFKA_TOPIC", "transaction-analysis")
MODEL_SERVICE_URL = os.getenv("MODEL_SERVICE_URL", "http://model-service:8000")


# 创建 Redis 客户端,将读取的内容解码为字符串。
redis_client = redis.from_url(REDIS_URL, decode_responses=True)


# 创建 PostgreSQL 连接。
def db():
    return psycopg.connect(DATABASE_URL)


# 处理一条交易分析任务。
def process_message(message):
    # 读取业务交易编号和数据库内部编号。
    payload = message.value
    external_id = payload["external_id"]
    transaction_id = int(payload["transaction_id"])

    # 使用业务交易编号生成 Redis 完成标记的键名。
    done_key = f"fincross:transaction:{external_id}:done"

    # 已有完成标记时跳过预测和数据库写入。
    if redis_client.exists(done_key):
        print(f"skip duplicated message external_id={external_id}", flush=True)
        return

    # 将任务中的九个特征发送给模型服务,等待预测结果。
    response = requests.post(
        f"{MODEL_SERVICE_URL}/predict",
        json=payload["features"],
        timeout=15,
    )

    # HTTP 请求失败时抛出异常,成功时读取 JSON 结果。
    response.raise_for_status()
    result = response.json()

    # 在同一个事务中保存预测结果并更新交易状态。
    with db() as conn:
        with conn.cursor() as cur:
            # 将模型版本、风险概率和风险等级写入预测表。
            cur.execute(
                """INSERT INTO predictions
                   (transaction_id, model_version, risk_probability, risk_level)
                   VALUES (%s,%s,%s,%s)""",
                (transaction_id, result["model_version"],
                 result["risk_probability"], result["risk_level"]),
            )

            # 将交易标记为已完成评分。
            cur.execute(
                "UPDATE transactions SET status='SCORED' WHERE id=%s",
                (transaction_id,),
            )

        # 两项写入均成功后提交事务;发生异常则回滚。
        conn.commit()

    # 数据库提交成功后保存完成标记,有效期为一天。
    redis_client.set(done_key, "1", ex=86400)

    # 输出处理结果,flush=True 让容器日志及时显示。
    print(
        f"scored external_id={external_id} "
        f"probability={result['risk_probability']:.6f}",
        flush=True,
    )


# 启动消费者,持续读取 Kafka 任务。
def main():
    consumer = KafkaConsumer(
        # 订阅 Data Service 发布任务的主题。
        KAFKA_TOPIC,
        bootstrap_servers=KAFKA_SERVERS,

        # 同一消费组的 Worker 按分区分担任务。
        group_id="fincross-risk-worker",

        # 关闭自动提交,由代码在处理成功后提交进度。
        enable_auto_commit=False,

        # 没有有效消费进度时,从仍保留的最早消息开始读取。
        auto_offset_reset="earliest",

        # 将消息中的 JSON 字节解码为 Python 字典。
        value_deserializer=lambda value: json.loads(value.decode("utf-8")),
    )
    print("worker started", flush=True)

    # 逐条处理收到的消息。
    for message in consumer:
        try:
            process_message(message)

            # 处理完成后提交消费进度,供后续恢复消费使用。
            consumer.commit()
        except Exception as exc:
            # 记录错误并等待三秒;此处不会自动重试当前消息。
            print(f"processing failed: {exc}", flush=True)
            time.sleep(3)


# 直接运行 worker.py 时启动消费循环。
if __name__ == "__main__":
    main()
4、构建镜像
模型文件尚未生成,Model Service 还不能提供预测,因此这里先只构建镜像,等模型训练完成、模型服务就绪后再启动 Worker。
项目根目录使用以下命令进行构建。
docker compose build worker
查看镜像构建是否成功。
docker image ls
(.venv) PS C:\Users\Ezekielx\PycharmProjects\fincross-risk> docker image ls
                                                                                                                                                                                    i Info →   U  In Use
IMAGE                                ID             DISK USAGE   CONTENT SIZE   EXTRA
apache/kafka:4.3.1                   77e3df905404        686MB          239MB    U
fincross-risk-data-service:latest    c5381d7a71d9        291MB         68.8MB    U
fincross-risk-gateway:latest         8c1444c4da57        258MB         62.2MB
fincross-risk-model-service:latest   24048d1ba4e3       1.31GB          451MB
fincross-risk-worker:latest          02ab908e4d9e        239MB         56.5MB
postgres:18.6                        4ef4dbc939d6        650MB          168MB    U
redis:8.10.1                         298e5b3bc566        212MB         57.5MB    U
(.venv) PS C:\Users\Ezekielx\PycharmProjects\fincross-risk>
列表中出现 fincross-risk-worker,且构建命令没有报错,说明镜像构建成功。